資料來源#
- Full-Duplex Speech Models Take the Floor When Asked, Not When Needed
- Interaction Models: A Scalable Approach to Human-AI Collaboration
- NemotronLabs VoiceChat: An Open Full-duplex Speech-to-Speech Model with Tool Calling Capabilities
- Toward Native Multimodal Modeling: A Roadmap
摘要#
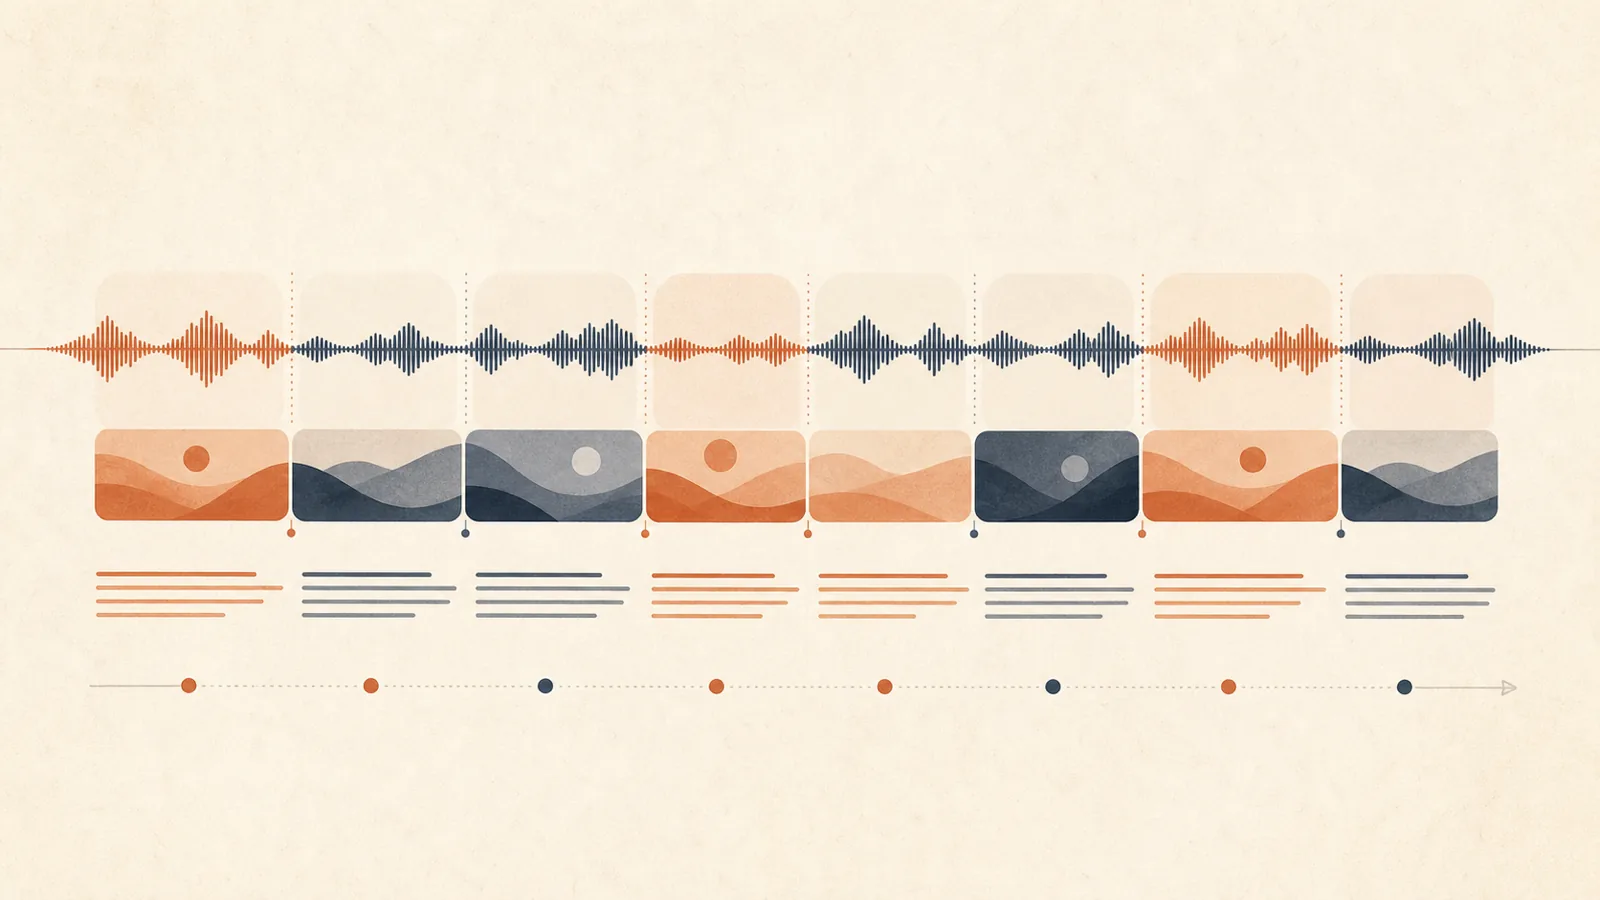
Interaction Models 的核心架構做法是:不再接收完整的使用者回合再輸出完整回應,而是將輸入與輸出視為連續串流,以約 200ms 的區塊(「微回合」)處理並生成,彼此交錯。模型不必遵守人為設定的回合邊界——靜默、重疊和打斷都會保留在模型的脈絡中。
運作方式#
- 模型持續交錯處理:處理 200ms 輸入 → 生成 200ms 輸出 → 處理下一段 200ms 輸入 → …,涵蓋音訊、影片和文字。
- 人類感知會保留並行的輸入與輸出串流;模型看到的則是單一交錯 token 序列(
input 0, output 0, input 1, output 1, …),編碼了相同的時間資訊。 - 由於時間資訊就在序列中,模型能直接感知經過的時間,並可在使用者回合進行中採取行動,而不必等到回合結束。
對照之下:以回合為單位的模型會看到具有明確回合邊界的交替 token 序列;即時互動感則由 harness 假造,方法是預測這些邊界(VAD 等)——請參閱 Turn-Based Interface Bottleneck。
為什麼是 200ms#
200ms 區塊夠小,能讓多種輸入/輸出模態近乎即時地並行處理。代價是:推論必須頻繁進行小型 prefill 和 decode,而且每次都受到嚴格的延遲限制——現有的 LLM 推論函式庫並非為此設計(每回合的額外負擔相當可觀)。
推論:串流工作階段#
TML 對頻繁小型 prefill 問題的解法:
- 用戶端將每個 200ms 區塊作為獨立請求傳送。
- 推論伺服器將區塊附加到 GPU 記憶體中的持續序列,避免重複配置記憶體及重新計算中繼資料。
- 此做法的某個版本已上游整合至 SGLang。
- 此外,還有針對雙向服務工作型態調校延遲的 kernels:例如 MoE kernels 使用 gather+gemv,而非標準 grouped gemm(引用 PyTorch/
gpt-fast和 Cursor 的 warp-decode 先前研究)。
Trainer-sampler 對齊#
逐位元 trainer-sampler 對齊用於提升訓練穩定性,也用來除錯系統元件。此方法透過 batch-invariant kernels 實作,端到端額外負擔低於 <5%。其中強調了兩種 kernels:
- All-reduce / reduce-scatter — NVLS 低延遲通訊 kernels,在 Blackwell 上具決定性,在不同平行化策略間逐位元對齊(Sequence Parallelism 與 Tensor Parallelism)。
- Attention — Split-KV 通常會造成 decode 和 prefill 的累積順序不一致;解法是在 decode 和 prefill 間採用一致的切分方式(例如每次 4096 個 tokens,從左側對齊),同時維持兩者的效率。
它帶來的效益#
如今需要專用 harness 的每一種互動模式,都會成為模型行為的特例,並隨著模型規模和訓練資料增加而改善:主動插話、同時說話、對視覺線索做出反應、估算時間。請參閱 Full-Duplex Interaction。
(2026-09-21 由 Peng et al. 加註限定,empirical。 此機制移除了在使用者回合中採取行動的限制,但不會提供採取行動的理由。在五個開放式全雙工模型家族的七種配置中——理論上全都能在回合中途說話——錯誤主張或迫近危險讓語音起始時間相較基準至多移動 .06;受到稱呼以及實際停頓,則最多移動 +.24 和 +.73。五個模型中有兩個完全不會打斷進行中的語音。而兩個專為互動性進行後訓練的模型,在內容線索出現時反而比基礎檢查點更安靜。因此,「隨著模型規模和訓練資料增加而改善」這句話,就目前有人測量的唯一面向而言,還不能用來形容主動插話。請參閱 Content-Driven Intervention。)
交錯機制的第一手來源:Moshi 的 12.5 Hz(透過 NMM roadmap,2026 年 5 月)#
TML 將交錯描述為一種設計(以約 200ms 間隔排列 input 0, output 0, input 1, output 1, …),但沒有公布影格率或每影格的 token 配置。An, Lu, Dong et al. 的調查(practitioner-opinion)指出,在其盤點的 43 個模型中,Moshi 是唯一公布相關資訊的開放模型:Moshi 以 12.5 Hz 影格交錯文字與音訊,每個時間步結合一個文字位置和八個音訊 codebook 位置——也就是 80ms 一個影格、文字與音訊 token 比例為 1:8,並具體回答了「一個區塊」包含什麼。
有兩點讓這個資訊值得超越單純的數字換算來看。
交錯機制是預訓練限制,不只是推論排程。 調查將此列在模態混合排程之下,這是它對一種技術的稱呼:在早期融合中,一旦各模態的 loss heads 消失,這種技術便不可或缺,因為每個 batch 中的混合比例會直接決定梯度方向。同一段也提到:Moshi 將一半的預訓練 batches 分配給純文字資料,作為統一 loss 下維持語言能力的明確防遺忘緩衝;其 RVQ 語義 codebook 的 loss 權重 α = 100,而聲學 codebook 的 α = 1。因此,以微回合粒度串流的模型也必須在訓練資料混合比例上付出代價——這個頁面先前未曾注意到這點。
**它與其他早期融合模型中可比較的數字並列,**因此能看出這是設計選擇,而非固定常數:Transfusion 將文字對影像 token 比例固定為 1:1,並在 80% 的情況下先放置說明文字,再放影像;Chameleon 則將每張影像固定為 1,024 個 tokens,不論來源解析度如何,皆取自 512×512 中心裁切,因此每張影像的梯度都固定。Moshi 的 1:8 是這個家族中專為音訊串流設計的成員。
注意事項:這是調查轉述 Moshi 自身論文的內容,不是實測;而調查的評估表只將 Moshi Eval 列為200ms 目標延遲基準——這是目標,不是實際結果。
同一格線的第二個第一手來源,並將回合邊界設為訓練目標(NVIDIA,2026 年 9 月)#
上文提到的 Moshi 12.5 Hz 交錯資訊是透過調查取得。NemotronLabs VoiceChat(NVIDIA,arXiv 2609.21967,2026-09-18,empirical)則是針對同一影格格線的第一手來源,並公布 Moshi 說明中沒有提到的部分:模型實際上在每個影格中接受什麼預測訓練。
格線。 一個具快取感知能力的 600M FastConformer encoder,透過因果式深度可分離步幅縮減,以八倍因子下採樣,每 80ms 輸出一個 encoder 狀態——與 Moshi 相同的 12.5 Hz 影格,但源自串流 ASR 系譜,而非 RVQ codec。Self-attention 使用 70 個影格的左側脈絡,且沒有右側脈絡;卷積採因果方式;產生目前狀態不需要未來音訊。在輸出端,TTS codec 也以 12.5 Hz 運作,每 80ms 波形產生一個 31 層 RVQ 影格。系統兩端採用相同格線,但不共享梯度。
回合邊界成為影格層級的目標,權重提高了整整一個數量級。 agent-text 通道是一條填補過的時間軸:BOS 設在回應開始處,接著在連續影格中放入回應的子詞 tokens;EOS 則是在與下一個使用者回合短暫重疊後的停止目標,其餘位置全都是 padding。論文直接說明其結果——「因此,BOS 和 EOS 會作為影格層級的輪流發話目標:BOS 教模型何時開始回應,EOS 教模型何時停止,而 padding 教模型保持靜默。」 SFT loss 權重清楚表明優先順序:**回合開始權重為 12.5、回合結束為 7.5、文字內容為 5.0、padding 為 1.0。**因此,交錯不只是模型服務時採用的方式——何時發話與說什麼一樣,都是在同一格線上進行監督訓練的目標,而且權重更高。
兩種會形塑格線的增強方式,以及一項刻意的不對稱設計。 以回合為單位的訓練資料並未監督雙工行為,因此 SFT 會加入相關資料:提早打斷以 p = 0.1 的機率,在隨機的 agent 回合中途截斷話語,並在 EOS 前繼續 八個影格(640ms),使下一個使用者回合與 agent 語音重疊;附和語注入則以每筆樣本 p = 0.05 的機率,在 agent 說話期間將音量相符的錄製「uh-huh」音訊注入使用者通道,避免模型把應答誤判為打斷。還有一項文字通道延遲:SFT 期間將 agent 文字目標往後移 兩個影格(160ms),讓模型在承諾輸出每個 token 前取得更多使用者音訊;而函式通道明確不延遲,以「保留每次工具呼叫的實際時間位置」。在同一時間軸上執行兩個輸出通道的系統,可以延遲其中一個而不延遲另一個;這種控制粒度,是上述單一交錯圖像所沒有的。
(同一來源中的平衡觀點。 §4 還附帶一個啟發式端點偵測器,當學得的行為失效時會強制注入 BOS/EOS——因此影格層級的輪流發話目標另有語音/靜音活動規則作為後盾,並非單獨信任模型。詳情請見 Full-Duplex Interaction。)
延伸閱讀#
- Native Multimodal Modeling: Fusion Depth and I/O Duality — Moshi 的 12.5 Hz/每個文字位置搭配八個音訊 codebook 的交錯方式,是微回合的第一手來源呈現;模態混合排程則是其所屬的早期融合訓練限制
- Interaction Models — 上位概念
- Turn-Based Interface Bottleneck — 此設計取代的做法
- Encoder-Free Early Fusion — 讓串流成為可能的互補「最少前處理」選擇
- Interaction / Background Model Split — 微回合讓互動模型保持在線;深度推理則交由外部處理,避免串流停滯
- Full-Duplex Interaction — 解鎖的能力
- Content-Driven Intervention — 此機制提供行動機會,而非行動理由:在五個開放式雙工家族中測量主動插話,結果顯示此能力不存在
- The Bitter Lesson — 「沒有回合邊界 → 互動模式成為可擴展的模型行為」是直接應用
- Context Window Smart Zone — 以 200ms 粒度持續輸入音訊/影片會快速累積脈絡;開放式長工作階段問題
- Interactivity Benchmarks — 輪流發話延遲(0.40s)是移除回合邊界所帶來的直接實測效益
- TML-Interaction-Small — 以此機制打造的模型(200ms 交錯輸入/輸出區塊)
- Live-Path Minimalism — 更高一層的正式服務端對應做法:GPT-Live 的具狀態串流推論(持續工作階段、無縫執行個體交接、將壓縮移出即時路徑)解決了相同的持續推論問題;其分塊細節未公開,而 TML 的串流工作階段則已公開並上游整合
資料來源#
- Interaction Models: A Scalable Approach to Human-AI Collaboration
- Full-Duplex Speech Models Take the Floor When Asked, Not When Needed — Peng、Nuchged、Fu 與 Yao,arXiv 2609.19596,2026-09-17(
empirical):對「隨著模型規模和訓練資料增加而改善」的限定。完整分析請見 Content-Driven Intervention - NemotronLabs VoiceChat: An Open Full-duplex Speech-to-Speech Model with Tool Calling Capabilities — Balam、Bartley、Casanova 等人(NVIDIA),arXiv 2609.21967,2026-09-18(
empirical,19 頁):§2.1 的 80ms encoder 格線、零右側脈絡和 BOS/EOS 影格層級輪流發話目標;§2.3 的 12.5 Hz/31 層 RVQ codec 影格;§3.2 的 agent-text loss 權重 12.5/7.5/5.0/1.0;§A.3 的提早打斷、附和語注入、兩影格文字通道延遲及不延遲的函式通道。這是第一手來源,並非調查轉述;NVIDIA 對自家系統的單次執行結果。完整分析請見 Full-Duplex Interaction - Toward Native Multimodal Modeling: A Roadmap — An、Lu、Dong 等人(Tencent Youtu Lab 與五所大學;arXiv 2605.25343,2026-05-25;
practitioner-opinion):§5.1.3 模態混合排程——Moshi 的 12.5 Hz 文字/音訊交錯(每個時間步一個文字位置加八個音訊 codebook 位置)、一半純文字的防遺忘緩衝、α=100/α=1 codebook 權重,以及 Transfusion/Chameleon 混合比例比較。這是調查轉述 Moshi 自身論文的內容,不是實測。完整分析請見 Native Multimodal Modeling: Fusion Depth and I/O Duality
Cited by 14
- Full-Duplex Interaction×3
Turn-taking here is a trained frame-level behaviour (BOS/EOS as per-frame targets on the agent-text…
- Encoder-Free Early Fusion×2
Avoids the latency and complexity of large standalone encoders/decoders — important when you have…
- Interaction / Background Model Split×2
a time-aware interaction model that maintains real-time presence — perceiving and responding in a…
- Interaction Models×2
Time Aligned Micro Turns, Interaction Background Model Split, Encoder Free Early Fusion — the three…
- The Bitter Lesson×2
Time Aligned Micro Turns — remove artificial turn boundaries so interaction modes become scalable…
- TML-Interaction-Small×2
Interaction mechanism: Time Aligned Micro Turns — 200ms interleaved input/output chunks, no turn…
- Turn-Based Interface Bottleneck×2
The Bitter Lesson says these hand-crafted systems get outpaced by general capability growth → the…
- Content-Driven Intervention
Time Aligned Micro Turns — the mechanism that makes acting during the user's turn possible at all;…
- Cursor
Earlier Cursor engineering also shows up obliquely: warp-decode kernels are cited as prior art for…
- Interactivity Benchmarks
Time Aligned Micro Turns — turn-taking latency (0.40s) is the direct payoff of removing turn…
- Live-Path Minimalism
Time Aligned Micro Turns — TML's disclosed counterpart on the inference internals: persistent…
- Interaction & Multimodal
Time Aligned Micro Turns — The core interaction-model move: input/output as continuous streams in…
- Native Multimodal Modeling: Fusion Depth and I/O Duality
Time Aligned Micro Turns — Moshi's 12.5 Hz text/audio interleave (one text position + eight audio…
- NVIDIA
Time Aligned Micro Turns — VoiceChat is the corpus's second primary source on the 80 ms duplex…
Related articles
- Interaction Models
Thinking Machines Lab (May 2026): models that handle audio/video/text interaction natively in real time instead of via…
- Full-Duplex Interaction
Perceive-and-respond simultaneously across modalities — a property of scheduling, not of emitting in speech; proactive…
- Interaction / Background Model Split
Dual-model architecture: a time-aware interaction model stays present while an async background model handles deep reas…
- Interactivity Benchmarks
FD-bench, Audio MultiChallenge + TimeSpeak/CueSpeak (proactive audio) and RepCount-A/ProactiveVideoQA/Charades (visual…
- Native Multimodal Modeling: Fusion Depth and I/O Duality
An, Lu, Dong et al. (Tencent Youtu + 5 universities, May 2026) formalize 'native' as two operator definitions — mid-fus…