資料來源#
- Claude Fable 5 and Claude Mythos 5
- CS329A Self-Improving AI Agents — Part 8: Agentic Evaluations and Long-Horizon Tasks
- Expenditure Horizon: Measuring Optimization Ability, with an Application to NanoGPT
- GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks
- More compute, more capability: Why AI agent evaluations need to account for test-time compute
- Really Big Test-Time Compute in AI Changes Benchmarks, Safety and Research with OpenAI's Noam Brown
- SWE-Bench Pro Verified: A Reliable Benchmark for Software Engineering Agents
- When AI builds itself
摘要#
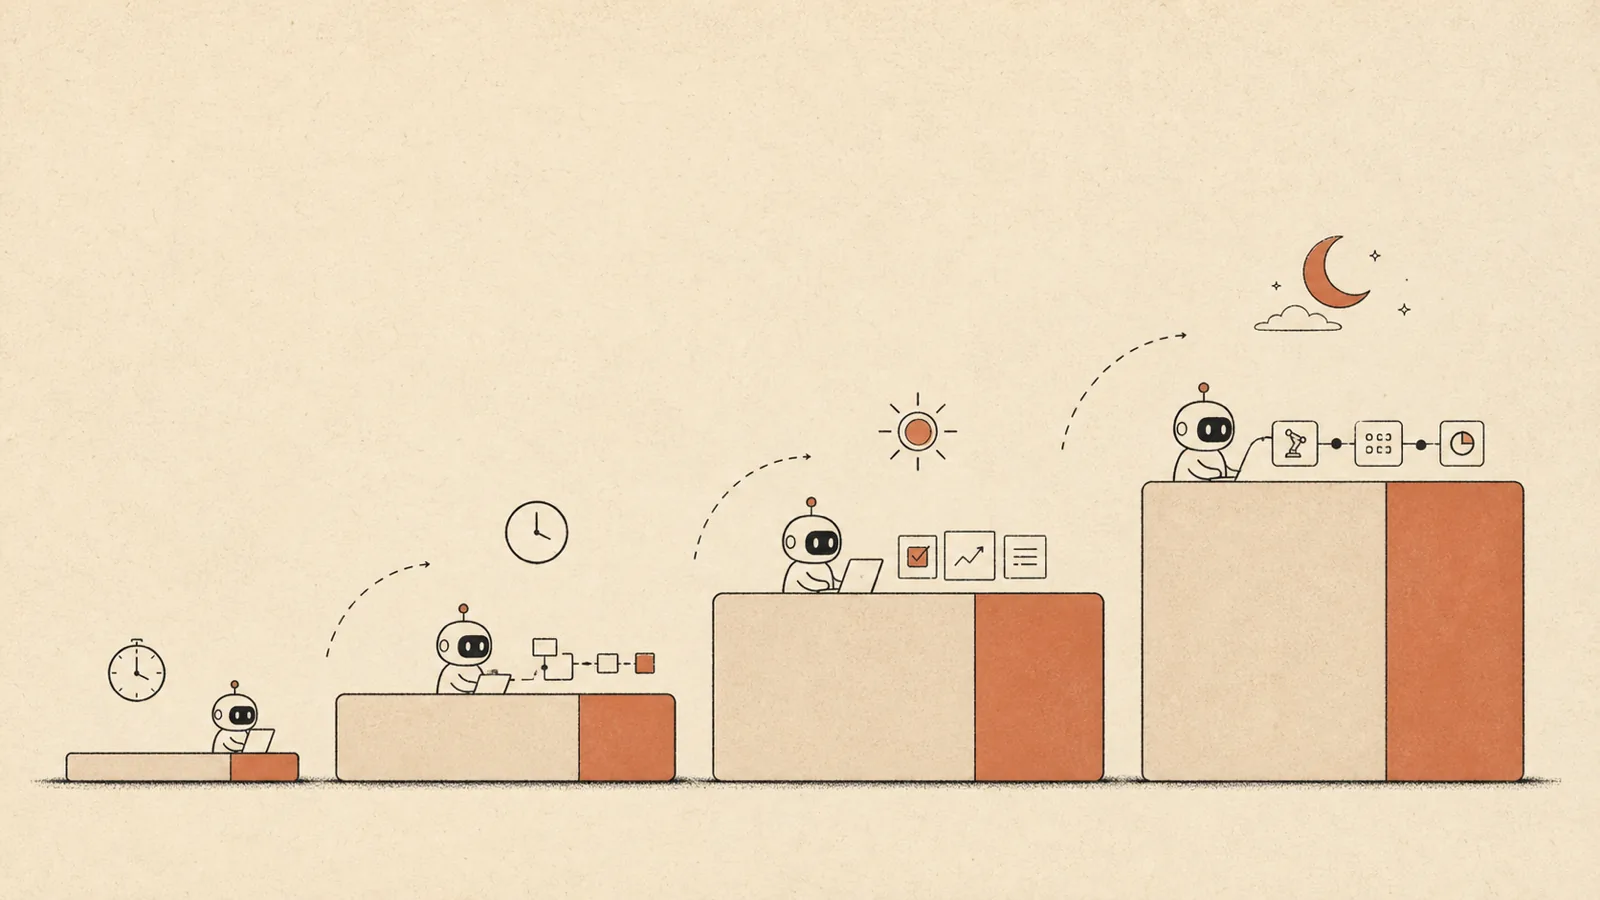
遞迴式自我改進背後的外部基準趨勢線顯示:AI 能獨立可靠完成的任務長度,大約每四個月就會翻倍——比早先約七個月翻倍的速度更快。這項指標來自 METR 的時間跨度研究,衡量模型在一組任務中能以 50% 可靠度完成任務的時間長度(在 80% 可靠度下,曲線形狀也相同)。這是《When AI builds itself》的量化主軸:AI Accelerating AI Development 說明 AI 如何在 Anthropic 內部加速 AI 工作,這裡則呈現底層能力如何在公開基準上提升。
翻倍曲線#
| 模型 | 約略日期 | 可靠完成的任務長度 |
|---|---|---|
| Claude Opus 3 | 2024 年 3 月 | 約 4 分鐘 |
| Claude Sonnet 3.7 | 約 2025 年 3 月 | 約 1.5 小時 |
| Claude Opus 4.6 | 約 2026 年 | 約 12 小時 |
| (預估) | 今年 | 數天 |
| (預估) | 2027 年 | 數週 |
Mythos Preview已到達可測量性的邊界:METR 發現它能工作「至少」16 小時,而且「已接近 [METR] 在不新增任務的情況下可測量的上限」。趨勢的加速(從 7 個月翻倍縮短至 4 個月)才是關鍵——這也解釋了為何文章主張,這個循環可能「比多數機構準備好的時間還早」就會閉合。
2026 年 6 月 Mythos 級模型的發布又更進一步:Fable 5 / Mythos 5「能比以往任何 Claude 模型自主工作更久」,具體數據是長達一週、絕大部分時間自主進行的基因體學工作(蒐集資料、設計並訓練模型、超越已發表的基準,見自主科學發現)。長達一週的自主研究已遠超 METR 可測量的任務集合——如今,指標追趕的是能力,而非為能力劃定上限。
方法,以及前身曲線(2025 年末課堂講授)#
本頁視為已被取代的「約七個月翻倍」速率,可從 CS329A 第 8 堂課完整還原(Aakanksha Chowdhery,2025-11-17 授課,practitioner-opinion,數據透過 ASR 從投影片讀取)——這也是本文唯一說明數字如何得出、而非只引用數字的來源。
三套任務集,約 170 項任務,涵蓋五個數量級的執行時間:
| 任務集 | 時長範圍 | 約略任務數 | 內容 |
|---|---|---|---|
| SWAA | 1–30 秒 | 約 66 | 原子操作(開啟檔案、做一項小修改) |
| HCAST | 1 分鐘 – 30 小時 | 約 97 | 多元的軟體與研究工程任務 |
| RE-Bench | 最長約 8 小時 | 約 7 | 完整的 ML 研究任務 |
人類基準是整套測量工具的核心:具備約五年經驗的專業人士記錄成功嘗試的完成時間,而任務難度評級取基準測試者的幾何平均數。Chowdhery 指出這會帶來偏差——熟悉某領域的從業者會系統性地低估該領域任務的難度,而且他們對難度的感受未必符合模型認為困難的地方。接著以模型執行結果計算每項任務的成功率,擬合成功率對人類完成時間的曲線,再取曲線達到所選可靠度的位置作為時間跨度。一位學生提出顯而易見的釐清問題,而答案值得記錄:50% 指的是多次嘗試後各任務的成功率,再跨任務取平均——不是保證每項任務都超過 50%。
前身階梯,以 50% 可靠度計:GPT-2(2019)約 2 秒 → GPT-4(2023)約 8 分鐘 → Claude 3.7 Sonnet(2025)約 59 分鐘。(注意與上表不同:上表記錄 Anthropic 自身文章所列 Sonnet 3.7 約 1.5 小時。59 分鐘是課堂依 METR 論文講授的數字;兩者都在資料集內,也都未被撤回。)
可靠度落差是這堂課的主標題,而且幅度超出本頁原先呈現的範圍:在**80%**可靠度下,同一批前沿模型的時間跨度約為 8–15 分鐘,而 50% 時是 59 分鐘——講課在同一段落中同時說「8 到 10 分鐘」和「15 分鐘」,因此應理解為數十分鐘,而非一小時。80% 曲線的翻倍速度相近,只是整體平移,沒有變平。Chowdhery 的說法是:50% 可靠度的代理程式就像「一位只有一半時間能完成工作的實習生」,而部署到真實工作時,得看 80% 那一欄。
課堂列出的三項限制(都是 METR 自己提出的):
- 混亂的任務得分較差——凡是沒有單一正確答案的任務,都低於趨勢線。
- 以 SWE-bench 推導的估計值偏短。 標註者低估 SWE-bench 任務的難度,而且模型看過大多數 GitHub 儲存庫,因此在這些任務上擬合出的翻倍時間,相較於未見過的儲存庫會顯得過度樂觀——汙染造成的是斜率誤差,而不只是水準誤差。
- 模型表現像缺乏上下文的低資歷承包人員,而非維護者。 在內部拉取請求上,不熟悉程式碼庫的承包人員比維護者慢 5–18 倍;模型表現符合承包人員的時間,因為模型也從未看過該程式碼庫。這堂課提出的解讀值得保留:時間跨度衡量的是一位聰明的新手在沒有上下文時能做什麼,因此上下文不對稱和領域專業知識會一再成為人類貢獻的剩餘部分。
失敗分類法解釋了可靠度為何不足(比較 GPT-4 與 o1,因此是特定時期的資料):規劃不佳(沒有拆解步驟)、工具選擇不當、心算或推理錯誤、過早放棄——在迴圈裡反覆打轉,始終沒認出完成應該是什麼樣子——以及明顯的重複迴圈,失敗的行動仍是機率最高的行動,於是再次輸出。推理模型的訓練明顯減少最後一類(o1 遠低於 GPT-4),其餘類型則仍然存在。
這堂課也提供了一項相反方向的測量工具:GDPval中,模型相對人類專業人士的勝率,在本頁曲線翻了五次倍的同兩年間,大致呈線性上升。兩者在同一堂課上被視為互補而非競爭的指標——前者是在固定可靠度下看任務時長,後者則是在固定任務下看產出品質。
GDPval 原始論文(arXiv 2510.04374,empirical,2026-09-10 收錄)為這項對照補上兩點——一點削弱它,一點強化它。 削弱之處:GDPval 圖 6 中「隨時間大致線性進步」的主張,是以三個 OpenAI 模型擬合而成(GPT-4o 12.4% → o3 high 34.1% → GPT-5 high 38.8%);經常被一併引用的 47.6%,則是 Claude Opus 4.1 在另一張沒有時間軸的圖上的分數。三個點不足以描述翻倍,因此對照仍成立——但引用時應標示樣本數 n,而且線性曲線止於 38.8%,不是 48%。強化之處:GDPval 圖 13 衡量的是對照專家完成時間的勝率,從品質面得到的時長梯度,形狀正是時間跨度的樣子。Claude Opus 4.1 在 0–2 小時任務得分 56%(高於 50% 平手線),2–4 小時為 44%,4–8 小時為 42%,8 小時以上為 37%;GPT-5 high 則為 48 / 33 / 35 / 30。對人類的品質會隨任務長度下降,與本頁衡量可靠度的軸相同;在現有資料中,這最接近兩項指標測量同一種底層衰退的證據。
時間跨度及其翻倍速率本身取決於預算(UK AISI)#
UK AI Security Institute 於 2026 年 7 月發表的研究(empirical)指出,上述翻倍曲線未提到一個混淆因素:模型估計出的時間跨度,以及時間跨度的翻倍速度,都取決於評估允許的運算預算。 時間跨度數字只有相對於某個預算才有定義。
在 AISI 範圍較窄的網路 CTF 任務集上,若以每項任務 2.5M 個 token 衡量,自 2024 年末以來,前沿時間跨度每 4.7 個月翻倍——與 METR 在另一組(一般用途)任務上得到的約 4 個月相近。但若以更高預算重新擬合同一任務集,曲線會更陡:
- 每項任務使用 50M 個 token 時,擬合出的前沿趨勢比 2.5M 個 token 時陡約 60%。AISI 自己的解讀是:「估計出的翻倍速率部分是評估所用運算預算造成的結果,而不是前沿網路能力進展的固定屬性。」
- 以單一模型來看,某個近期前沿模型的 80% 時間跨度從2.5M 個 token 時約 40 分鐘,上升到 50M 個 token 時約 4 小時;在目前的前沿水準,將預算從 2.5M 提高至 50M,會使估計時間跨度從約 2 小時升至約 14 小時。
背後機制是 AISI 的另一項發現:代理程式所需的運算量,會隨熟練人類完成任務所需時間增加——在 AISI 的 78 項網路 CTF 任務與 METR 的 211 項軟體工程任務中,符合指數約 0.7–1.0 的冪律(一分鐘任務約需數千個 token,一小時約需數百萬個,一週約需數十億個)。即使只看每項任務成本最低的成功執行,這個關係仍成立;因此下限由任務本身需要的工作量決定,而非效率低落。由於較長任務需要更多運算,固定預算會先在最長的任務上耗盡——因此有上限的評估會系統性低估時間跨度,而長任務失敗可能代表執行預算不足,不代表模型缺乏能力。AISI 的網路任務「The Last Ones」(人類約需 20 小時)直到預算達到 ≥30M 個 token 後才有模型解出;在 Epoch 的 MirrorCode 上,某個近期模型最多花了十億個 token,才在先前模型無法完成、相當於數週人工作業的任務上取得進展。
這重新界定了本頁的核心數字。每約 4 個月翻倍的現象確實存在,但這是在隱含預算下得到的統計值;若用更高預算衡量,前沿看起來還會移動得更快。這條曲線是否穩定呈指數成長,如今也與第三個問題糾纏在一起——採用什麼預算?——此外還有下文將談到的指數曲線或 S 曲線之爭。
METR 自己提出的後繼指標:支出時間跨度(2026 年 7 月)#
AISI 從外部提出批評;METR 於 2026 年 7 月發表的支出時間跨度說明(empirical),則是同一組織提出替代測量工具。在「與時間跨度的關係」一節中,它明確指出本頁指標的兩項限制,並表示新工具旨在解決這些問題:
- 二元通過/失敗會丟失任務連續評分所含的資訊。 連續分數「能為每項任務提供統計上精確得多的能力衡量,也就是用更少觀測值就能偵測模型差異」。
- 預算沒有明確標示。 時間跨度「沒有完整界定 AI 代理程式或人類的 token 或其他資源預算與限制……」METR 承認,在代理程式成本仍低於人類、進步停滯時,這點影響不大;一旦不再如此,影響就很大——也就是 AISI 在上文測量、且指標作者承認的預算依賴性。
替代方法不是使用一組由人類計時的任務,而是採用一道已由人類高度最佳化的問題:繪出代理程式累積改善量對累積支出的曲線,在相同座標軸上繪出人類勞動的局部報酬,再回報兩條曲線交會時的支出。在 NanoGPT 速度挑戰中,人類每提升 1% 速度約需 $2,500;六次代理程式執行各自最多花費 $10,000,重新驗證後得到的時間跨度為 $0–$3,300,其中兩次正好為零,因為看似有進展的結果其實只是雜訊。
有三件事它沒有做到,而且應清楚區分。這是單一問題的概念驗證——METR 直言「理想情況下,我們會在幾個不同的困難最佳化問題上測量支出時間跨度」,因此這裡沒有任何結果能取代整組任務。它需要具有平滑、連續評分報酬的問題,適用範圍比本頁任務集所涵蓋的任務更窄。它還會在有趣的終點消失,而非延伸:只有在代理程式的報酬遞減速度快於人類報酬時,這項指標才有定義;一旦觸發自動化 AI R&D 門檻,指標就不再存在。
基準測試飽和所提供的佐證訊號#
同樣的模式也出現在基準測試從接近零分走向「飽和」(約 100%,但錯誤可能使許多基準測試無法達到 100%):
- SWE-bench——提供模型一個真實開放原始碼程式碼庫和錯誤報告,要求它做出能通過專案自有測試的修改。從個位數低分到飽和只花了兩年。(參見 Claude Opus 4.8:在 SWE-bench Verified 得分 88.6。)
- CORE-Bench——根據程式碼與資料重現已發表論文的結果;這是進行原創研究的先決條件。從約 20%(2024 年)到飽和只花了十五個月。
其中一部分飽和來自檢索,而這個因素如今已被量化。 SWE-Bench Pro Verified(Zheng 等人,2026-09-08,empirical)重建了 SWE-Bench Pro 的 731 個實例,使代理程式無法再取得上游修正提交——任務取自真實提交,且實例 ID 內含目標 SHA——並重新測試七個模型。最高分從 89.06% 降至 62.93%;七個模型中有六個失去 14–26 分;第七個模型先前被稽核發現幾乎只是鑽漏洞,分數則只降 0.05。儲存庫層級的長期任務正是答案仍可被檢索到的任務,因此膨脹現象恰好在時間跨度主張最有力的地方最嚴重。這不影響 METR 自己的時間跨度數字——其任務集並非根據公開提交建立——但代表本頁所引用的「SWE-bench 系列飽和」佐證,同時混合了能力與檢索兩種因素,而兩者所占比例直到現在才被揭露。完整討論見評估時答案洩漏。
這就是為何時間跨度,而非單一基準的準確率,已成為更有資訊量的能力軸;也解釋了為何模型超越人類最佳基準後,Anthropic 退役了以任務為基礎的 AI-R&D 基準(見 AI R&D 自主性評估(AECI))。
注意事項#
- 基礎設施負荷是領先指標,不只是趣聞。 GitHub 在 2025 全年約有 10 億次提交;到 2026 年年中,每週約 2.75 億次(年化速度約 140 億次),並表示正「極力擴充」容量——這是同一波吞吐量激增所造成的下游跡象。
- 時間跨度數字是在一組任務上以 50% 可靠度計算的統計值;任務集內的鋸齒狀表現是真實存在的——能處理 12 小時任務的模型,仍可能在簡單任務上失敗。
- 世代曲線也同樣鋸齒起伏。 AISI 彙總出的「新模型觸及範圍更廣、可靠度更高、效率更好」掩蓋了少數退步情況:在約 10–30% 的任務(視任務集而定)上,新模型實際上比前代更差(AISI註腳)。觸及範圍、可靠度和效率平均而言確實提升,但底下仍有鋸齒起伏——這是世代之間的鋸齒狀表現,不只發生在單一任務集內。
- 曲線究竟是真正的指數成長,還是正接近轉折點的 S 曲線,是遞迴式自我改進第一種未來明確提出的不確定性。
- 發布週期如今短於測出能力上限所需的時間。 Noam Brown(OpenAI,
practitioner-opinion)指出,真正評估代理程式處理數月期任務的唯一方法,就是讓它執行那麼久;但新模型每兩到三個月就會發布,因此模型在有人充分執行、找出能力上限之前就已退役(「沒有人真的知道能力上限是什麼……沒有人讓它們跑得夠久」)。長期代理程式能力發布時,人們直到一週後、第一批為期一週的執行結束,才意識到它的重要性。受限於結構設計,測得的時間跨度總是落後真實能力——這是從評估角度看到的潛在能力懸置,也是大規模測試時運算難以測到效能停滯點的同一原因。
延伸閱讀#
-
評估時間跨度與發布節奏——將這條曲線讀成比率,而非趨勢。若可靠任務長度約每四個月翻倍,而前沿模型每兩個月發布一次,分子最終會超過可供評估的時間間隔——這就是前沿從業者「一週 → 一個月 → 三個月」階梯的量化形式。
-
Headroom-Closed Index(HCI)——另一項獨立測量工具也認同剩餘能力所在的位置。METR 衡量代理程式能可靠完成的任務時長;HCI 衡量各基準測試標準化能力餘裕已消除多少,到 2026 年,工具代理程式為 39.9,軟體工程為 52.6,研究所程度科學為 85.8——從分數而非任務長度得出同樣結論:長時間、有狀態、需要互動的工作,離上限最遠。
-
評估時答案洩漏——受到部分修正的飽和佐證訊號:在 SWE-Bench Pro 上封堵執行時答案檢索,使七個模型中六個失去 14–26 分、領先模型失去 26.13 分,因此本頁引用的 SWE-bench 系列曲線有一部分反映檢索,而非能力。這種依賴只有單向——本頁的 METR 測量不受影響——但任何倚賴公開儲存庫基準的時間跨度論證,如今都得面對答案洩漏問題。
-
遞迴式自我改進——外推這條曲線,就是循環可能很快閉合的量化論據。
-
AI Accelerating AI Development——與這些外部基準證據相對應的內部吞吐量分析。
-
鋸齒狀智慧(幽靈,而非動物)——任務集內的注意事項:長時間任務的能力與簡單任務的失敗並存。
-
苦澀的教訓——一般基準能力持續上升,正是手工打造鷹架的優勢逐漸縮小的原因。
-
AI R&D 自主性評估(AECI)——說明飽和的任務型基準為何從 RSP 評估中退役。
-
為下一個模型打造——本指標測量、可預測的能力曲線,使「押注下一次發布」成為合理的產品策略,而非賭博。
-
自主科學發現——Mythos 5 長達一週的自主基因體學執行,是一項具體的長時間任務數據,超越 Mythos Preview 測得的 16 小時上限。
-
Effective Compute Scaling——與能力面趨勢線互補的運算面曲線;Whitfill 等人依運算預測建立時間跨度成長模型。
-
AGI-to-ASI Pathways——提供具體能力趨勢線,支援報告的量化預測與超越人類基準測試議程。
-
Intelligence Explosion Dynamics——讓「曲線正彎向奇點,還是呈 S 曲線?」成為可透過實證檢驗的指標。
-
Deep Research Agents——深度研究是本指標衡量的典型長時間自主任務;DRACO 在該時間跨度上評分報告品質。
-
DRACO Benchmark——相關的能力基準(代理式研究報告品質,對照模型可持續工作的任務長度);兩者都面臨基準飽和壓力(DRACO 捨棄了超過 90% 已解出的任務)。
-
Production-Sourced Evaluation——從即時使用情況更新的方法,回答本頁提出的開放問題:飽和的任務集應如何替換。
-
Repository Exploration Subagent——SWE-bench 系列(Multilingual / Pro / Verified / SWE-QA)是 FastContext 的評估範圍;時間跨度最長的版本(SWE-bench Pro)顯示最大進步,符合探索成本隨任務時長累積的預期。
-
規劃/執行分工——此處衡量的能力上限(模型能自主做到什麼)與使用者實際授予的已實現自主程度;Anthropic 引用 METR 的時間跨度,視其為高於使用資料所顯示範圍、且持續上升的能力上限。
-
Agentic Coding Work-Composition Shift——可靠任務長度上限提升,是使用方式從除錯轉向端對端操作/分析完整工作流程的上游原因。
-
Conversation-to-Delegation Shift——從使用面解讀這項能力上限:OpenAI 的 Codex 研究發現,自 2025 年 12 月以來,委派一項估計需要超過 8 小時熟練人力的任務之個人使用者比例,從 2.1% 升至 25.6%——任務複雜度正緊貼 METR 測得的時間跨度攀升。
-
Parallel Agent Orchestration——長時間執行代理程式的執行環境餘裕(OpenAI 使用者每日代理程式時數 p99 約 71 小時),是低於可靠任務長度上限的單一代理程式任務時長。
-
暴露分類:觀察、理論、回報、預期——理論暴露(LLM 可能做到什麼)受此可靠任務長度上限約束;調查中的已回報/預期暴露則低於上限。
-
AI 原生建構的三個循環——曲線上的一個軼聞點:Andrew Ng 的程式設計代理程式無人看管地工作「大約一小時,使用網頁瀏覽器檢查它做了什麼」,之後才回來找他。
-
大規模測試時運算——可靠任務長度曲線是以能力指標衡量的同一論點;讓模型搭配鷹架執行數週/數月,就是花費推論預算之處。
-
潛在能力懸置——無人測量的上限:發布節奏短於讓模型執行至極限所需的時間。
-
Compute-Controlled Benchmarking——在明確預算下的可靠任務長度,是運算控制指標;兩者都取代單一數字準確率,也都要對抗基準飽和。
-
Benchmark Score Redundancy——從冗餘角度看飽和:飽和基準在不同模型間的分數差異幾乎為零,正是 BenchPress 的 rank-2 矩陣中基準變得極易預測的原因——因此飽和既削弱本頁的指標,也讓分數可從其他基準推知。
-
超越準確率飽和的衡量方式——「CORE-Bench 飽和後該怎麼辦」的補充分析:本頁指出 CORE-Bench 在 15 個月內飽和;Nadgir 等人以這項已飽和基準為例,展示六個非準確率軸(構念效度、OOD 穩健性、效率、可靠性、模型與鷹架的貢獻、人類與代理程式的提升)仍可區分代理程式,主張重新設計測量工具,而非退役基準。
-
UK AI Security Institute——測得時間跨度及翻倍速率依賴預算,以及運算需求對人類時間的冪律關係的評估機構;沿用 METR 的任務集。
-
Noam Brown——「評估一個能執行一年的代理程式,唯一方法就是讓它跑一年」這個觀點的來源。
-
開放權重前沿差距——Arena Elo 衡量聊天偏好;33 Elo 的開放/封閉差距是否也適用於長時間代理式工作,是時間跨度問題,而非偏好問題。
-
支出時間跨度——METR 自己提出、以金額表示的連續型後繼指標,旨在修正此處指出的兩項限制(二元評分、預算未明);它在一道前沿最佳化問題上測量,而非使用任務集,並且在代理程式報酬不再比人類報酬更快遞減時失去定義。
-
Frontier AI Standards Body——將翻倍曲線視為監管節奏問題:Hassabis 提議設立一個機構,由其基準集合界定哪些模型納入監管範圍,並「或許先按季度」更新。對監管機構而言,季度更新很快;對照本頁趨勢線卻很慢,而提案沒有說明,模型在界定範圍的基準退役後、下一季才跨越監管邊界時該如何處理。
-
GDPval Benchmark——與本指標一同講授、用來制衡樂觀推論的數據:模型在實際付費工作上,對平均具備 14 年職業經驗的專業人士的勝率。其線性趨勢是僅三個資料點、只納入 OpenAI 模型的擬合,終點為 38.8%(47.6% 是競爭模型在截面圖表上的分數);自身的時長梯度——0–2 小時為 56%,降至 8 小時以上的 37%——則是以品質而非可靠度衡量本頁所呈現的衰退。同一堂課,外推方向相反。
-
上下文優勢,而非品味——時間跨度衡量的是什麼:模型表現符合缺乏上下文的承包人員耗時(在內部 PR 上比維護者慢 5–18 倍),因此量得的是聰明新手,而非融入團隊的專家。
-
代理式程式設計中的專業知識回報——承包人員與維護者差距所呈現的人類面向:基準測試者帶來的是領域脈絡,而幾何平均錨點取自具備這種脈絡的人。
-
推理與行動交錯(ReAct)——在 2022 年基準中呈現的小型累積效應:在 WebShop 上,ReAct 的成功率低於逐步得分,因為「這是多步驟流程,[而且] 錯誤會隨時間層層累積」——本頁將同一種算術轉化為時間跨度。
-
以基準門檻治理:義務得以建立於指數之前必須證明什麼——翻倍曲線說明,依基準定義的法律邊界會在結構上持續衰退,而非偶然失效。能力約每 4 個月翻倍,基準約每 15 個月飽和,代表任何邊界基準都會在一個法定週期內過時;而能解決問題的季度更新,又會破壞義務所需的指涉固定性。
開放問題#
- 4 個月翻倍代表穩定狀態,還是局部陡升?趨勢的形狀(指數曲線或 S 曲線)尚未確定。補充(2026-07):AISI 指出,翻倍速率本身也依賴預算——同一網路任務集以每項任務 50M 個 token 衡量時,比 2.5M 個 token 快約 60% 翻倍——因此若不標示評估預算,標題所列速率便沒有明確定義。穩定性問題如今與預算問題交纏,而不只是指數曲線或 S 曲線之爭。
- 時間跨度是在一組本身也會飽和的任務上測得;一旦數週長的任務變得可測量,該用什麼取代這些任務,又由誰建立?部分回答/重新界定(2026-07):Nadgir 等人主張不要替換,而要重新設計測量工具:他們採用上文提到、15 個月內飽和的 CORE-Bench,展示準確率飽和後,六個非準確率軸仍能區分代理程式。因此「飽和任務集該由什麼取代」的答案可以是「保留並改用不同方式測量」,而非「建立更難的任務」。這處理的是準確率飽和,而不是本頁任務集遇到的時間長度指標飽和,也沒有回答誰來建立下一批數週長的任務——因此它重新思考了退役的慣性,卻沒有解決問題。METR 自身提供的第二個部分答案(2026-08):支出時間跨度是這項指標的作者提出的第三種選項——既非「建立更難的任務集」,也非「重新設計舊任務集的測量工具」,而是改變測量對象:完全捨棄任務集,改用人類仍在持續改善的一項前沿最佳化問題,觀察代理程式的美元曲線在哪一點與人類曲線交叉。它不需要建立任務,因為它用速度挑戰排行榜作為測量工具,而排行榜會自我更新。但它付出任務集沒有的兩項代價:需要具備連續評分、報酬平滑的問題(適用範圍比一般任務集窄),並且需要逐一估算問題中人類勞動的報酬;NanoGPT 的估算採用了兩場貢獻者訪談、LLM 評審對 82 個 PR 的評分,以及自助法校正係數,最後仍得到一個 METR 稱為「高度不確定」的數字。
資料來源#
- GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks — Patwardhan 等人(19 位作者,OpenAI),arXiv 2510.04374 v1,2025-10-05,29 頁(
empirical)。此處引用兩項修正:§3.1 圖 6(線性主張是終點為 GPT-5 high 38.8% 的三點、僅 OpenAI 模型時間序列;Claude Opus 4.1 的 47.6% 則出現在圖 5,沒有時間軸)以及 A.2.5 圖 13(依專家完成時間分組的勝率,從 0–2 小時到 8 小時以上,於編譯時直接檢視——數值僅見於圖中)。由廠商撰寫的基準;完整利益衝突說明見 GDPval Benchmark。 - SWE-Bench Pro Verified: A Reliable Benchmark for Software Engineering Agents — Zheng、Shang、Jiang、Tian、Zhu、Ma、Yuan 與 Zhang(ECNU / Shanghai AI Lab / Fudan),SWE-Bench Pro Verified,arXiv 2609.08149,2026-09-08(
empirical,37 頁)。此處僅引用圖 1 中七個模型的 Baseline 與 Verified 對照(僅有圖像;已轉錄並與表 3 交叉核對)及其背後的隔離程序。完整討論見評估時答案洩漏。 - When AI builds itself —「Evidence from the outside world」一節(METR 時間跨度;SWE-bench / CORE-Bench 飽和;GitHub 提交量註腳)。
- Claude Fable 5 and Claude Mythos 5 —「能比以往任何 Claude 模型自主工作更久」;自主基因體學研究持續一週。
- Really Big Test-Time Compute in AI Changes Benchmarks, Safety and Research with OpenAI's Noam Brown — Noam Brown(No Priors,2026-06-26),
practitioner-opinion:發布週期短於讓模型執行至能力上限所需的時間,因此從未測得上限。 - Expenditure Horizon: Measuring Optimization Ability, with an Application to NanoGPT — Cunningham、Shetty、Cheng 與 Rush(METR,2026-07-21,
empirical):「與時間跨度的關係」一節中,該指標的組織作者指出二元通過/失敗評分與未明確指定資源預算是此方法的兩項限制,並提出以金額表示的連續交會點作為替代。完整討論見支出時間跨度。 - CS329A Self-Improving AI Agents — Part 8: Agentic Evaluations and Long-Horizon Tasks — Aakanksha Chowdhery,Stanford CS329A 第 8 堂課,2025-11-17 授課,2026-08-03 發布(
practitioner-opinion,YouTube 自動字幕逐字稿)。課堂講授的 METR 方法:SWAA / HCAST / RE-Bench 任務集構成與約 170 項任務總數、具約 5 年經驗的人類基準測試者與幾何平均難度評級、GPT-2 → GPT-4 → Claude 3.7 Sonnet 的 50% 可靠度階梯、80% 可靠度落差、列出的三項限制(混亂任務、SWE-bench 低估與儲存庫接觸、模型所符合的承包人員/維護者 5–18 倍差距),以及 GPT-4 與 o1 的失敗分類法。所有數據都是透過 ASR 從投影片讀取,因此均附帶保留語氣;Sonnet 3.7 的 59 分鐘數字與上表約 1.5 小時的數字衝突。 - More compute, more capability: Why AI agent evaluations need to account for test-time compute — UK AISI(2026-07-02,
empirical):80% 網路時間跨度及每 4.7 個月翻倍的速率都依賴預算(50M 相較 2.5M 個 token 時曲線陡約 60%;增加預算後時間跨度從 40 分鐘升至 4 小時、從 2 小時升至 14 小時);運算需求對人類時間的冪律關係(指數約 0.7–1.0),涵蓋 METR 的 211 項 SWE 任務和 AISI 的 78 項網路 CTF;「The Last Ones」(約 20 小時)需要 ≥30M 個 token;MirrorCode 執行使用 10 億個 token。
Cited by 48
- METR×5
METR (Model Evaluation & Threat Research) is an independent organization that evaluates frontier-AI…
- Large-Scale Test-Time Compute×4
Two further AISI findings sharpen downstream pages rather than this one: compute demand scales with…
- AI Accelerating AI Development×3
Capabilities-progress acceleration (time horizon, Epoch's ECI) — intrinsically lagging, observable…
- CS329A: Self-Improving AI Agents (Stanford)×3
One aside worth keeping as a late-2025 timestamp: she flags the Claude Sonnet 4.5 system card as…
- Expenditure Horizon×3
The post's "Relation to Time Horizon" section names two limitations of Kwa et al. (2025) and claims…
- Aakanksha Chowdhery×2
Task Time Horizon Scaling — lecture 8's first third: the only account in the corpus of how METR's…
- How Much Signal Do Public Benchmarks Still Carry — and What Replaces Them?×2
Benchmark level: accuracy saturates — and stays saturated even after the benchmark is repaired. On…
- Claude Fable 5×2
Autonomy. Fable 5 and Mythos 5 "can work autonomously for longer than any previous Claude models" —…
- Conversation-to-Delegation Shift×2
Task Time Horizon Scaling — delegated task complexity (the >8h-task share rising 2.1%→25.6%) is the…
- Deep Research Agents×2
Deep research is a long-horizon, autonomous, multi-step task — exactly the regime Task Time Horizon…
- Evaluation Horizon Versus Release Cadence×2
Task Time Horizon Scaling — the numerator of this page's ratio, measured: reliable task length…
- GDPval Benchmark×2
That matters because the linear-versus-exponential contrast with METR (Task Time Horizon Scaling)…
- Governance by Benchmark Threshold: What an Index Must Prove Before an Obligation Can Rest on It×2
Concept articles: Domestic Frontier Pacing and Frontier Ai Standards Body (the two proposals and…
- Headroom-Closed Index (HCI)×2
Task Time Horizon Scaling — the independent trendline that agrees on the conclusion: the residual…
- Measuring Beyond Accuracy Saturation×2
The paper is the concrete counter to the retire-and-replace reflex that Task Time Horizon Scaling…
- Mythos Model×2
Task Time Horizon Scaling — Mythos sits at the measurable edge of the time-horizon curve (16+ hours)
- Open Questions Backlog×2
Task Time Horizon Scaling: Time horizon is measured on task baskets that themselves saturate; what…
- The Open-Weight Frontier Gap×2
Task Time Horizon Scaling — Arena scores chat preference; whether the open/closed gap survives on…
- Planning / Execution Division of Labor×2
Task Time Horizon Scaling — the capability ceiling (what models can do alone) vs. this study's…
- Reasoning–Acting Interleaving (ReAct)×2
Task Time Horizon Scaling — why WebShop success rate trails WebShop score: per-step error compounds…
- Recursive Self-Improvement×2
Task Time Horizon Scaling — the external trendline (METR doubling every ~4 months) that makes the…
- The Three Loops of AI-Native Building×2
"Given a product specification and optionally a set of evals… have an AI agent write code, test its…
- Agentic Coding Work-Composition Shift
Task Time Horizon Scaling — the rising capability ceiling is the upstream cause: longer reliable…
- AGI-to-ASI Pathways
Task Time Horizon Scaling — a concrete capability trendline feeding the forecasting agenda
- AI R&D Autonomy Evaluation (AECI)
Task Time Horizon Scaling — the saturating task-based benchmarks (and the time-horizon curve that…
- Anthropic Institute
Public-facing trajectory analysis. When AI builds itself combines public benchmarks (Task Time…
- Autonomous Scientific Discovery
Task Time Horizon Scaling — "over a week of largely autonomous work" is a concrete long-horizon…
- Benchmark Score Redundancy
Task Time Horizon Scaling — benchmark saturation is redundancy seen from this page's angle: a…
- Benchmark Task Defects (Spec–Test Mismatch)
Task Time Horizon Scaling — the SWE-bench-family saturation curve it cites, now with a third…
- Build for the Next Model
The bet depends on a reliable release cadence and a forecastable capability curve (Task Time…
- Compute-Controlled Benchmarking
Task Time Horizon Scaling — the compute-controlled successor metric: reliable task length at a…
- Context Advantage, Not Taste
Task Time Horizon Scaling — the same asymmetry priced in duration: on internal pull requests,…
- DRACO Benchmark
Task Time Horizon Scaling — sibling capability benchmark; where METR measures task length a model…
- Effective Compute Scaling
Task Time Horizon Scaling — METR's time-horizon trendline is the capability-side complement to this…
- Evaluation-Time Answer Leakage
Task Time Horizon Scaling — SWE-bench-family saturation is one of the corroborating signals for the…
- Exposure Taxonomy: Observed, Theoretical, Reported, Anticipated
Task Time Horizon Scaling — theoretical exposure's ceiling is bounded by the reliable-task-length…
- Frontier AI Standards Body
A quarterly update cadence is fast by regulatory standards and slow by capability standards —…
- Intelligence Explosion Dynamics
Task Time Horizon Scaling — the trendline that makes "is the curve bending?" empirically checkable
- Jagged Intelligence (Ghosts, Not Animals)
Task Time Horizon Scaling — the within-basket caveat on the time-horizon metric: a model that nails…
- Latent Capability Overhang
Task Time Horizon Scaling — the ceiling nobody can measure: the release cadence is shorter than the…
- Evals & Benchmarks
Task Time Horizon Scaling — METR's measure of the task length AI can complete reliably on its own,…
- Noam Brown
That 10×-per-year human-solve-time ladder is his own construction and is worth holding beside…
- Parallel Agent Orchestration
Task Time Horizon Scaling — long-running single agents (the runtime margin) sit under METR's rising…
- Production-Sourced Evaluation
Task Time Horizon Scaling — sibling concern: benchmarks saturate, so the ability to refresh from…
- Repository Exploration Subagent
Task Time Horizon Scaling — the SWE-bench family (Multilingual, Pro, Verified, SWE-QA) is the…
- Returns to Expertise in Agentic Coding
Task Time Horizon Scaling — the expertise premium measured as a speed ratio and then handed to the…
- The Bitter Lesson
Task Time Horizon Scaling — rising general-benchmark capability is the curve that keeps shrinking…
- UK AI Security Institute
Task Time Horizon Scaling — shows the time horizon and its doubling rate are budget-dependent;…
Related articles
- Open Questions Backlog
Generated by `_system/lint.py --write-backlog`. Do not hand-edit. Domain and Watching sections carry one row per page —…
- Responsible Scaling Policy Evaluations
Anthropic's RSP gates deployment on pre-release capability evaluations in CBRN, automated AI R&D, and high-stakes misal…
- Compute-Controlled Benchmarking
Noam Brown's critique: the single-number benchmark grid is broken because it ignores test-time compute — plot performan…
- Large-Scale Test-Time Compute
Noam Brown's thesis that model capability is now a function of inference budget (tokens/cost/time): with good scaffoldi…
- Recursive Self-Improvement
An AI system autonomously designing and developing its own successor; Anthropic Institute's *When AI builds itself* arg…